生成預測
儲存模型對原圖和加霧圖片的答案。
**預測集(Prediction Set)**儲存模型的答案。這一步在 100 張原圖和對應的加霧圖片上執行偵測器;下一步才計算分數。
選擇輸入和測試範圍
- 開啟 Prediction Sets,選擇 New。
- 選擇
Helmet v2 full dataset和Helmet YOLO26 detector。 - 確認模型的
helmet對應資料集的helmet。如有類別對映提示,先完成處理。 - 在 Prediction coverage 中選擇 Configure → Robustness,只加入 Fog,強度 3,然後應用更改。
- 設定以下采樣選項。
| 選項 | 值 |
|---|---|
| Dataset split | Validation |
| Sample scope | Random examples |
| Sample count | 100 |
| Random selection seed | 42 |
| Fog seed | 0 |
| Minimum object confidence | 0.25 |
| Duplicate-box overlap | 0.5 |
選擇種子決定抽到哪些圖片;Fog 種子決定隨機霧的樣式。兩者用途不同,都應保留。
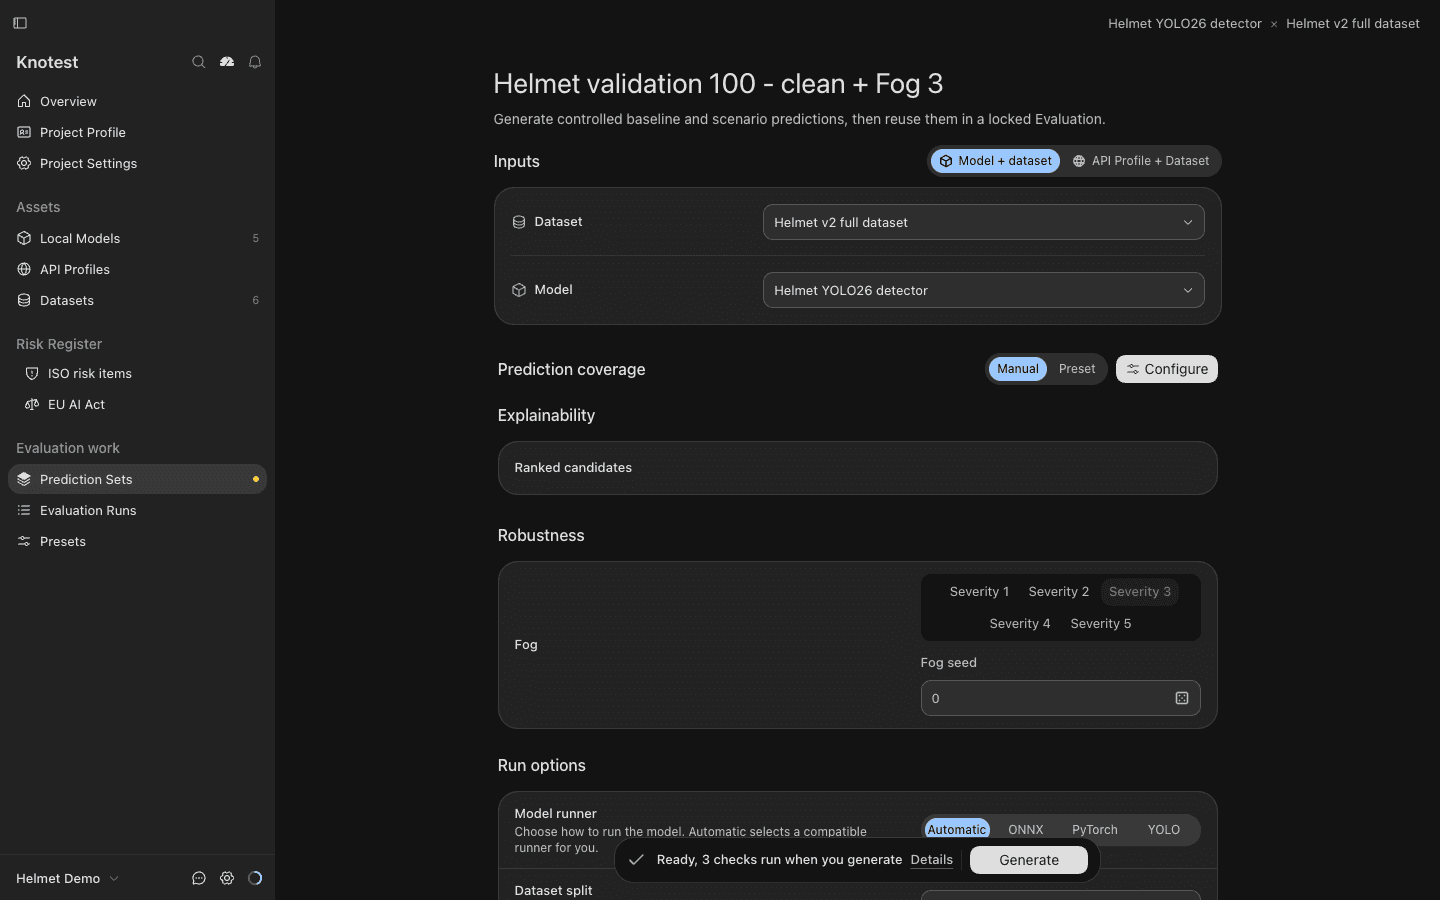
開始生成
繼續,將預測集命名為 Helmet validation 100 - clean + Fog 3。準備就緒後選擇 Generate。如果出現問題提示,使用旁邊的操作修正對應輸入或設定。
任務執行時保持 Knotest 開啟。你可以檢視其他頁面,再透過任務監視器返回進度。
完成後開啟預測集,核對樣本數量和覆蓋範圍。
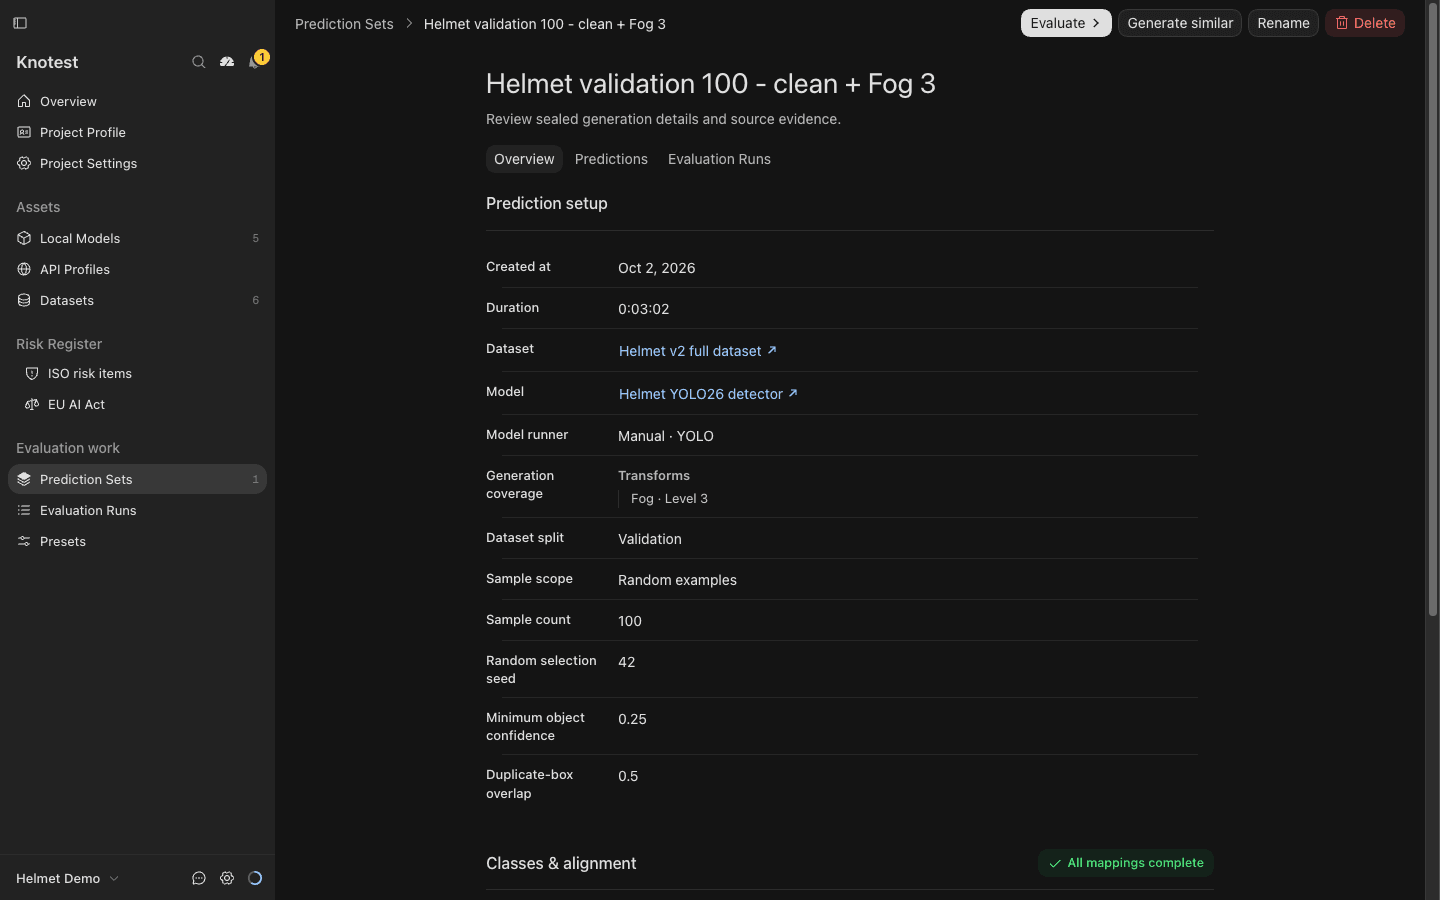
這次 Knotest 1.2.19 錄製中,信心分數門檻為 0.25 時,100 張圖片都顯示 No predictions。模型仍產生了較低信心分數的候選框,Knotest 會保留它們用於 mAP 評分。因此,圖庫沒有顯示偵測框時,mAP 仍可能不為零。這個模型適合學習流程,不能視為已驗證的安全帽偵測器。
儲存的預測集保持固定。更換模型設定、樣本或變換時,需要生成新的預測集;相容的指標和判定條件則可以重複使用現有答案。
下一步:執行評估。